

Содержание
- Для чего нужен robots.txt
- Где находится robots.txt
- Что содержит стандартный файл Joomla
- Как редактировать robots.txt из панели Joomla
- Как читать правила
- Как проверить CSS, JavaScript и изображения
- Как добавить карту сайта
- Когда нужен noindex в Joomla
- Как работать с дублями и параметрами
- Как проверить изменения
- Частые ошибки
- Заключение
Файл robots.txt управляет обходом сайта поисковыми роботами. В этой инструкции разберём стандартные правила Joomla, проверим доступность стилей и скриптов, добавим адрес карты сайта и выясним, когда вместо запрета обхода нужны noindex или canonical.
Для чего нужен robots.txt
Перед обходом сайта поисковый робот запрашивает файл robots.txt. Его правила показывают, какие адреса разрешено сканировать, а какие нужно пропустить.
Запрет обхода и запрет индексирования решают разные задачи. Если закрыть страницу в robots.txt, робот не сможет прочитать её содержимое. Однако сам адрес может остаться в поиске или попасть туда по ссылкам с других страниц.
| Задача | Подходящий способ | Что учитывать |
|---|---|---|
| Ограничить обход ненужных адресов | Disallow в robots.txt | Запрет не гарантирует исключения адреса из поиска |
| Исключить доступную страницу из поиска | noindex в метатеге или HTTP-заголовке | Робот должен иметь доступ к странице, чтобы прочитать указание |
| Указать основную версию среди дублей | rel="canonical" | Это сигнал поисковой системе, а не безусловная команда |
| Перенести страницу на другой адрес | Постоянный редирект | Посетители и роботы переходят на новый URL |
| Закрыть конфиденциальные данные | Авторизация и ограничения доступа | robots.txt не защищает данные от просмотра |
Где находится robots.txt
Файл должен открываться по адресу /robots.txt в корне сайта. Название пишется строчными буквами.
Если Joomla установлена в подпапке /joomla/, файл всё равно размещают в корне домена. Пути внутри правил должны учитывать подпапку:
User-agent: *
Disallow: /joomla/administrator/
Файл /joomla/robots.txt не заменяет корневой /robots.txt.
Правила относятся к тому сочетанию протокола, имени хоста и порта, с которого робот получил файл. Поэтому для основного домена и поддомена нельзя автоматически считать действующими одни и те же ограничения.
Проверяйте именно публичный адрес /robots.txt. Наличие файла в файловом менеджере ещё не означает, что сервер отдаёт его посетителям и роботам.
Что содержит стандартный файл Joomla
В Joomla есть файл robots.txt.dist с исходными правилами. Для обхода поисковые системы запрашивают robots.txt, поэтому важно проверить содержимое именно этого файла.
В стандартном наборе правил Joomla 6.2.0 запрещён обход служебных каталогов, включая /administrator/, /api/, /cache/, /components/, /libraries/, /modules/ и /plugins/. Каталоги /images/, /media/ и /templates/ этим набором правил не закрыты.

Поэтому утверждение, что современная Joomla по умолчанию запрещает роботам видеть все изображения, стили и скрипты, неверно. Проблема может возникнуть на конкретном сайте из-за старого robots.txt, дополнительных запретов или расположения файлов расширений.
Начните с трёх действий:
- Сохраните резервную копию действующего robots.txt.
- Сравните его с
robots.txt.distиз дистрибутива вашей версии Joomla. - Разберите отличия и назначение каждого дополнительного правила.
Не заменяйте существующий файл автоматически. В нём могут быть необходимые ограничения для магазина, фильтров, внутреннего поиска и других функций сайта.
Как редактировать robots.txt из панели Joomla
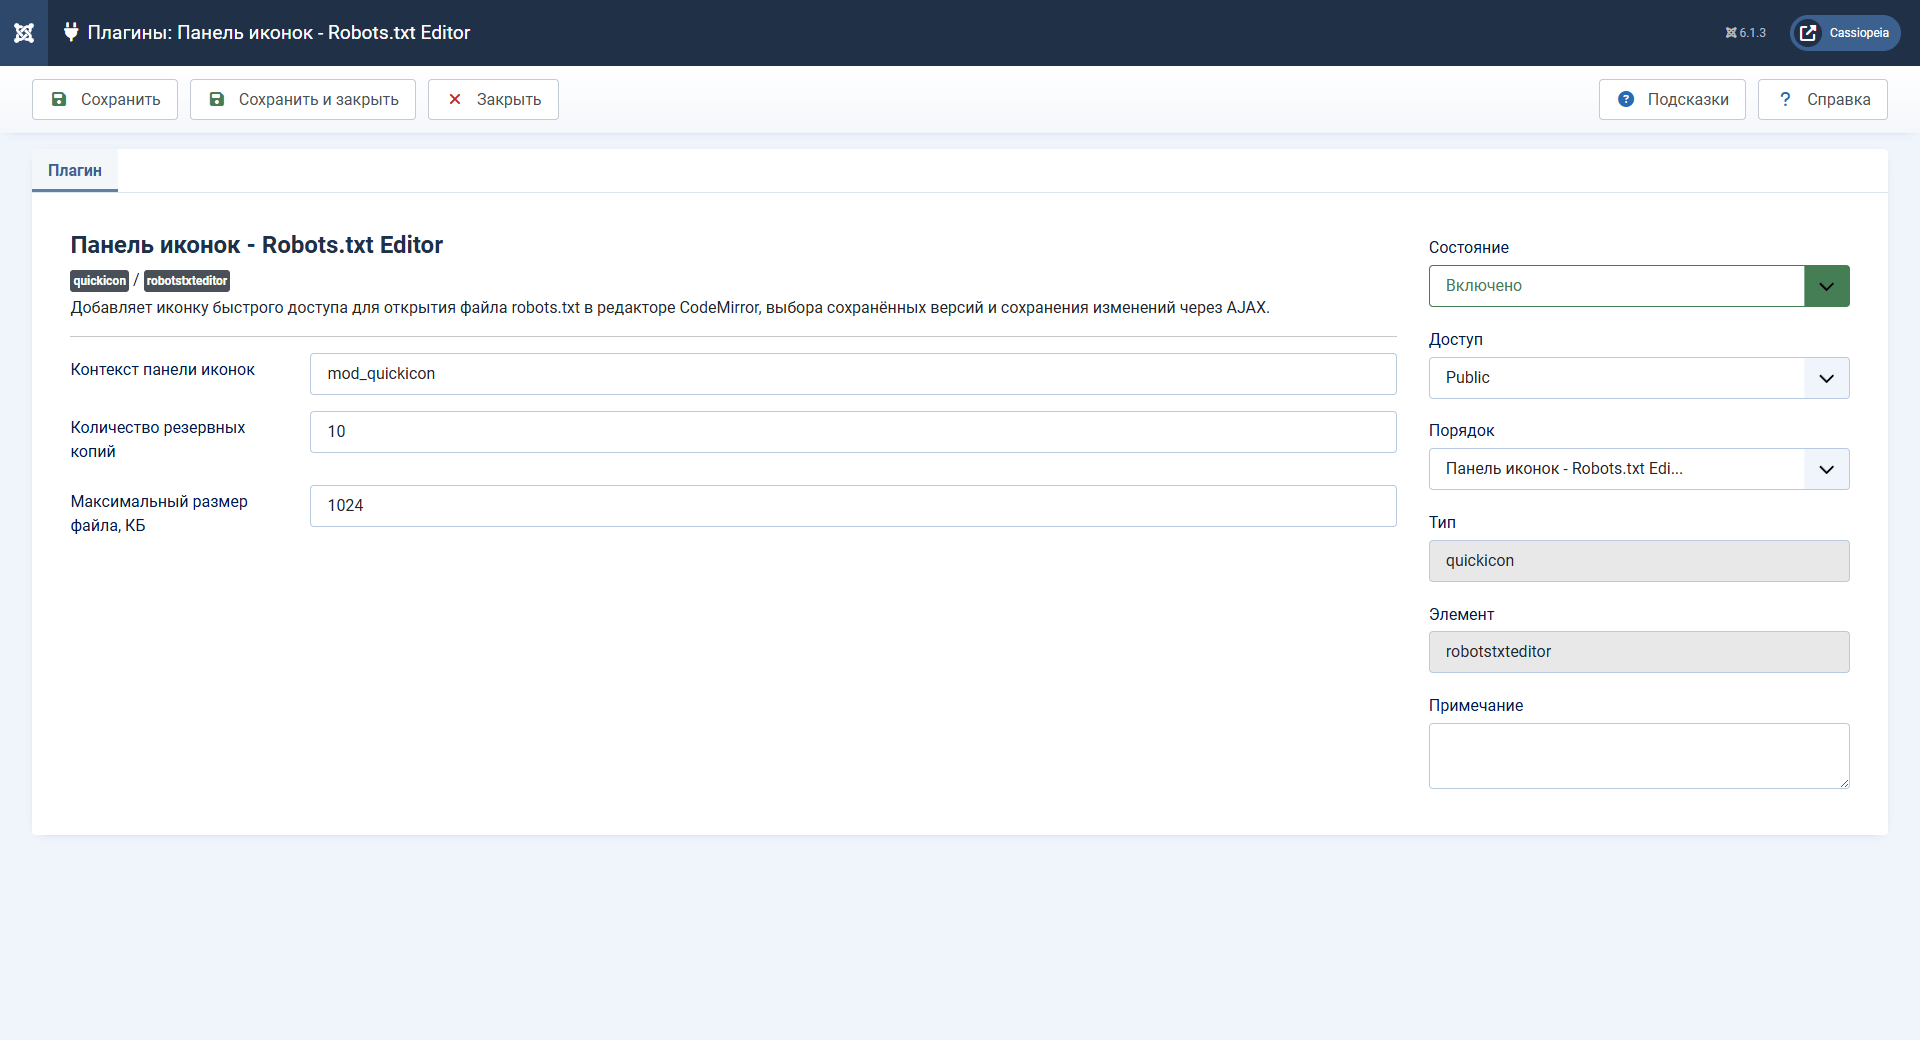
Для работы с файлом из административной части Joomla можно использовать плагин Robots.txt Editor. Он добавляет на главную страницу панели управления иконку быстрого доступа и открывает robots.txt в модальном окне.
Редактор CodeMirror подсвечивает код, а изменения сохраняются без перезагрузки страницы. Плагин хранит версии файла и позволяет восстановить предыдущую версию или стандартный robots.txt из Joomla.
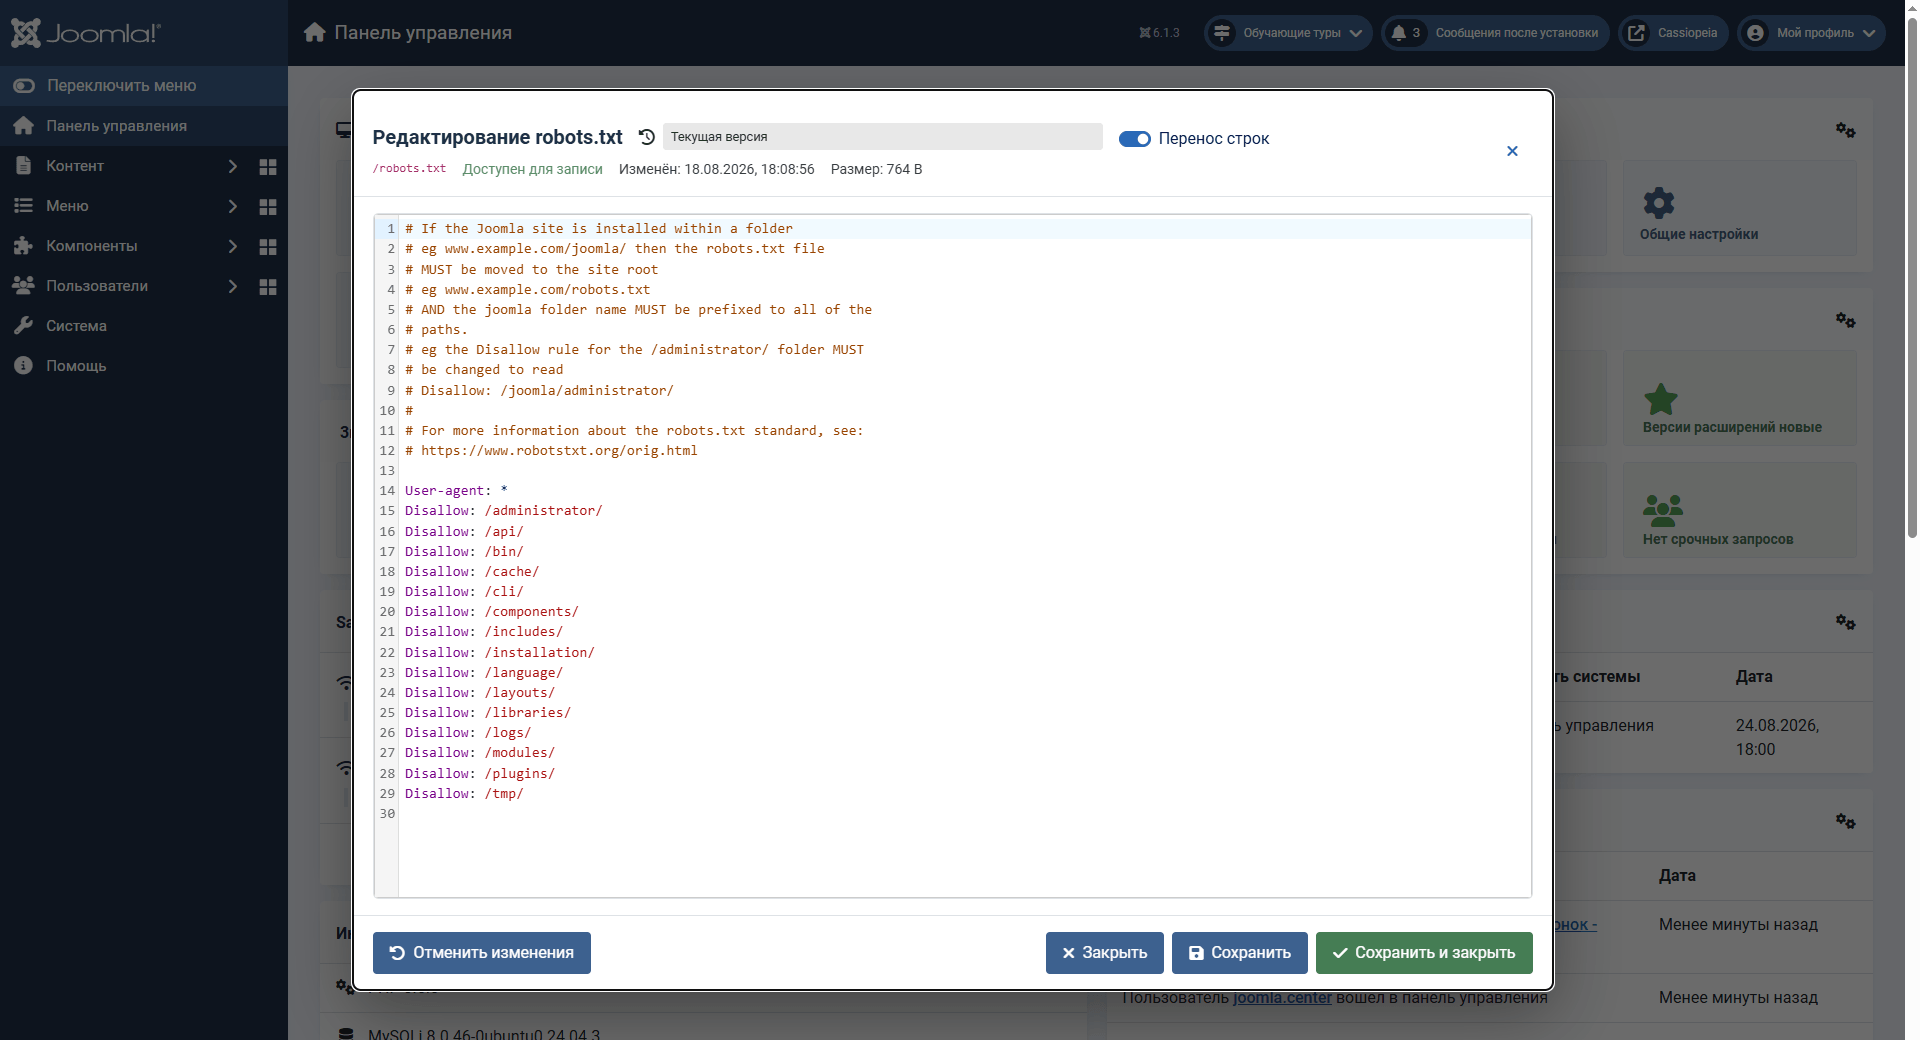
Перед восстановлением стандартного файла сохраните текущие правила, чтобы не потерять ограничения, добавленные для вашего сайта. После редактирования откройте публичный адрес /robots.txt и проверьте результат по инструкции ниже.
Как читать правила
Обычно достаточно одной общей группы правил. Например:
User-agent: *
Disallow: /administrator/
Disallow: /tmp/
User-agent определяет робота или группу роботов. Звёздочка обозначает общую группу. Disallow запрещает обход адресов, которые соответствуют указанному пути. Allow разрешает обход и может создавать исключение внутри запрещённого пути.
Если адрес не подпадает под запрет, отдельно разрешать его не нужно.
Пути чувствительны к регистру. Правила для /Images/ и /images/ не равнозначны. Символ * внутри пути используется как шаблон, а $ обозначает конец адреса.
Обратите внимание на разницу:
Disallow:Пустое значение не запрещает обход.
Disallow: /Такое правило запрещает обход всего сайта для роботов соответствующей группы.
Не создавайте отдельные группы Googlebot и Yandex без необходимости. В частности, Googlebot при наличии подходящей специальной группы не добавляет к ней ограничения из общей группы User-agent: *.
Как проверить CSS, JavaScript и изображения
Поисковому роботу нужны ресурсы, от которых зависит отображение и содержание страницы. Это могут быть стили, скрипты, изображения и ответы на запросы, загружающие контент.
В Joomla ресурсы часто находятся в /media/, /templates/ и /images/. Однако расширение может загружать их из собственного каталога, который закрыт стандартным или дополнительным правилом.
Проверяйте фактические адреса:
- Откройте важную страницу сайта.
- В инструментах разработчика браузера перейдите на вкладку Network.
- Перезагрузите страницу и найдите запросы CSS, JavaScript и изображений.
- Проверьте адреса ресурсов на соответствие правилам robots.txt.
- Убедитесь, что сервер отдаёт необходимые файлы без ошибок и требования авторизации.
Предположим, компонент загружает публичные ресурсы из /components/com_example/assets/, а весь /components/ закрыт. Для такого случая можно добавить более точное разрешение:
User-agent: *
Disallow: /components/
Allow: /components/com_example/assets/
Здесь com_example — условное имя. На своём сайте используйте существующий путь, который обнаружили при проверке.
Не открывайте целиком все каталоги расширений ради одного файла. Сначала определите, какие ресурсы нужны для отображения страницы.
Как добавить карту сайта
Директива Sitemap сообщает поисковой системе адрес карты сайта. Она не создаёт карту и не гарантирует индексирования перечисленных страниц.
Сначала найдите действующую XML-карту, которую формирует ваш сайт. Проверьте, что её адрес открывается без авторизации и возвращает XML, а не HTML-страницу ошибки.
Затем добавьте строку с полным адресом. Пример для условного домена:
Sitemap: https://example.com/sitemap.xmlЗамените пример реальным адресом. Название файла может отличаться от sitemap.xml. Если используется индекс карт сайта, укажите его адрес.
В карту включайте основные адреса страниц, которые должны участвовать в поиске. Не добавляйте туда заведомые дубли, перенаправления и страницы с noindex.
Адрес карты можно также передать через Google Search Console и Яндекс Вебмастер.
Когда нужен noindex в Joomla
Если страница должна оставаться доступной посетителям, но не должна появляться в поиске, используйте noindex. Для HTML-страницы это может быть метатег в разделе <head>:
<meta name="robots" content="noindex">В Joomla параметр Robots есть в общих настройках сайта, а также в метаданных отдельных материалов и ряда пунктов меню.
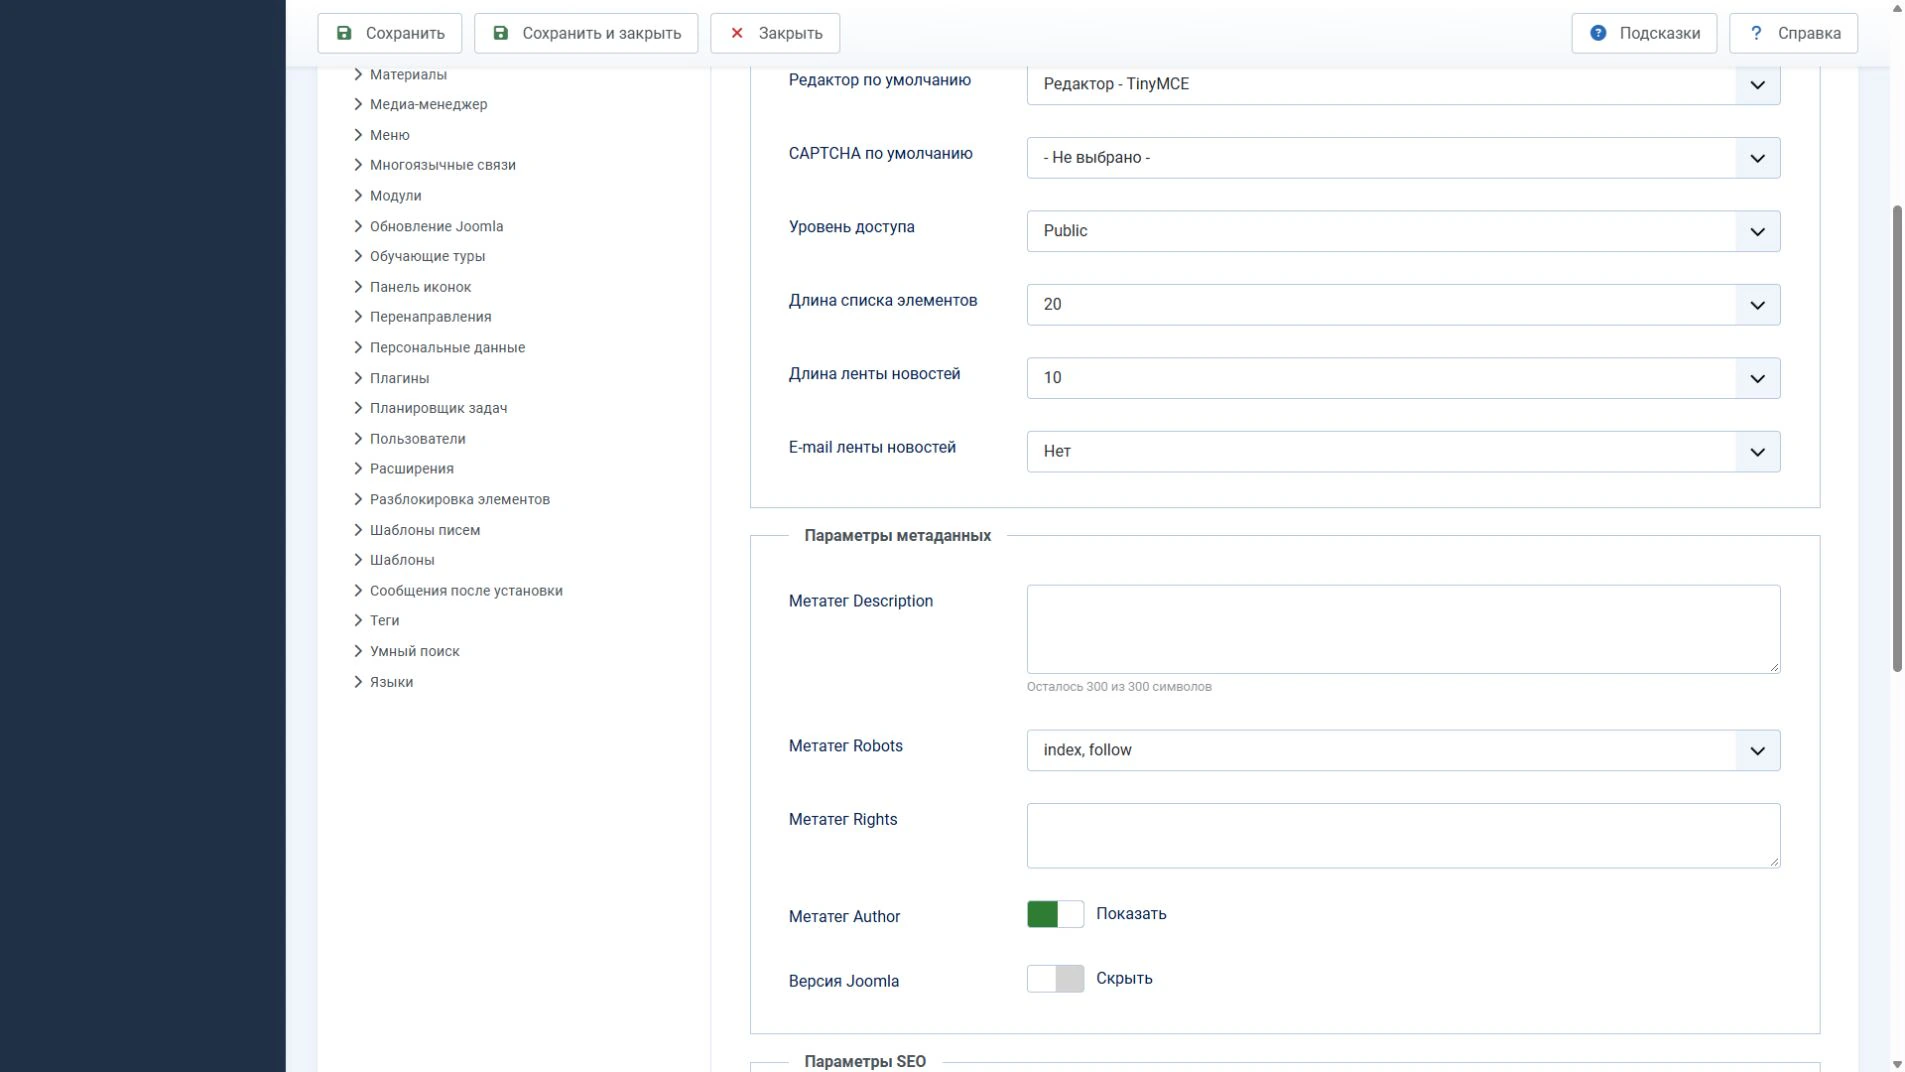
Для отдельной статьи откройте её параметры метаданных и выберите noindex, follow, если требуется исключить страницу из поиска без отдельного запрета следовать по её ссылкам.
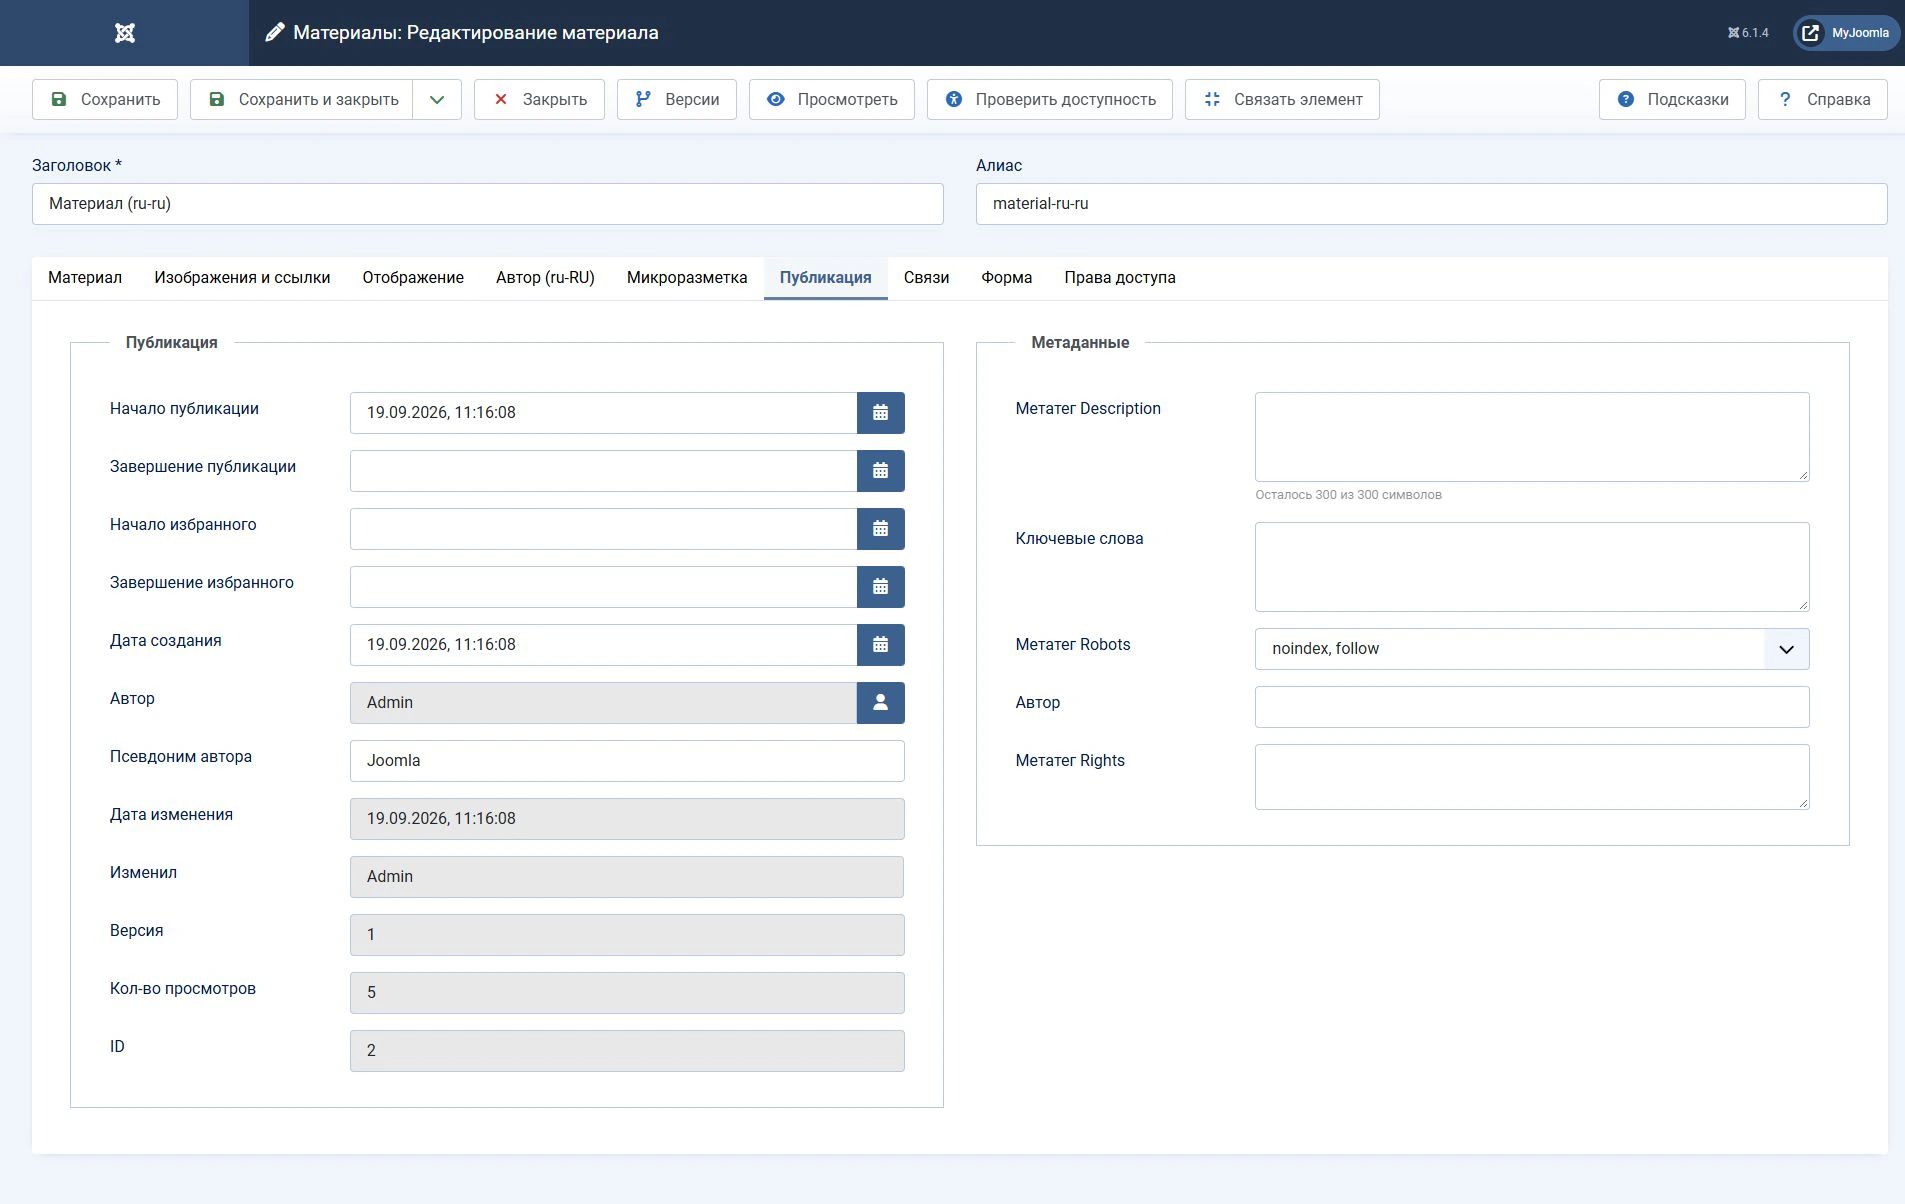
Не включайте общий noindex ради одного материала. Такое изменение может затронуть другие страницы сайта.
После сохранения проверяйте результат на публичной странице:
- В HTML присутствует нужный метатег robots.
- Обход этого адреса разрешён.
- HTTP-заголовки не содержат неожиданных указаний.
- Кеш не отдаёт прежнюю версию страницы.
Запись Noindex: внутри robots.txt не заменяет метатег. Google не поддерживает такой способ запрета индексирования.
Как работать с дублями и параметрами
Одна страница Joomla может открываться по нескольким адресам. Но одинаковый путь или наличие параметров ещё не доказывают, что перед вами дубли.
Сначала сравните содержимое страниц и их назначение. Если лишний адрес больше не нужен посетителям, рассмотрите постоянный редирект. Если варианты должны оставаться доступными и содержат одинаковый или почти одинаковый контент, используйте canonical.
Закрытый в robots.txt дубль робот не сможет полноценно изучить, в том числе прочитать canonical. Поэтому запрет обхода не следует использовать как универсальный способ выбора основного адреса.
Особенно опасно без проверки добавлять:
Disallow: /*?
Disallow: /index.php
Такие правила могут закрыть полезные страницы с параметрами, пагинацию и адреса сайта без настроенной перезаписи URL.
В Яндексе для параметров, которые не меняют содержание страницы, существует директива Clean-param. Её применяют после проверки конкретных параметров. Не используйте её для параметра, который выбирает другой материал или меняет значимую часть страницы.
Как проверить изменения
Проверка должна охватывать не только файл, но и страницы, ради которых вы его настраивали.
- Откройте
/robots.txtбез авторизации. Убедитесь, что сервер возвращает текст правил с кодом 200, а не страницу входа или ошибки. - Проверьте формат. Используйте обычный текстовый файл в UTF-8. Исключите случайное расширение
.txt.txt. - Проверьте важные адреса. Возьмите главную страницу, категорию, материал и страницу с параметрами, если такие адреса используются.
- Проверьте ресурсы. Стили, скрипты и изображения, необходимые для отображения, должны быть доступны роботу.
- Проверьте Sitemap. Указанный адрес должен вести на действующую карту сайта.
- Сверьтесь с инструментами поисковых систем. В Google Search Console используйте отчёт robots.txt и проверку URL. В Яндекс Вебмастере — анализ robots.txt и доступности страниц.
- Проверьте результат после повторного обхода. Поисковые системы кешируют robots.txt и не обязаны сразу учитывать изменения.
Локальная проверка помогает обнаружить ошибки правил, но не подтверждает доступность рабочего сайта для Googlebot или робота Яндекса.
Частые ошибки
Большинство проблем связано с чрезмерно широкими запретами или смешением обхода и индексирования.
- После запуска остался
Disallow: /. Проверьте, не перенесён ли запрет из тестового окружения. - Закрыты необходимые стили и скрипты. Проверьте реальные пути ресурсов и добавьте точные исключения.
- Страница одновременно закрыта в robots.txt и содержит noindex. Робот может не прочитать указание об исключении из поиска.
- Все адреса с параметрами считаются дублями. Сначала выясните назначение параметров.
- В Sitemap указан выдуманный адрес. Строка в robots.txt не создаёт карту сайта.
- Файл размещён в подпапке. Рабочий robots.txt должен находиться в корне соответствующего хоста.
- Robots.txt используют для защиты данных. Закрытые документы и резервные копии нужно защищать средствами сервера и авторизацией.
- Настройки проверяют только в Joomla. Итоговый HTML, заголовки и ответы сервера могут зависеть от расширений и кеширования.
Заключение
Для настройки robots.txt в Joomla начните с действующего файла и стандартных правил вашей версии. Добавляйте ограничения под конкретные задачи, сохраняйте доступ к ресурсам страницы и проверяйте адрес карты сайта.
Вносить правки и возвращаться к предыдущим версиям файла можно через плагин Robots.txt Editor прямо из панели управления Joomla.
Используйте robots.txt для управления обходом, noindex — для исключения доступных страниц из поиска, а canonical и редиректы — для работы с альтернативными адресами. Проверяйте результат на реальных URL и в инструментах поисковых систем.
Упоминаемые термины:
CSS, HTML, Админка, Плагин, Бэкап, Карта сайта, JavaScript, XML, Редирект

Комментарии